TL;DR
Agent 经常需要多路径探索、反复试错。数据分支就像给每次尝试准备一个独立的“实验场”,失败了可以直接丢弃,不影响其他分支。
数据分支的关键是写时复制:创建时共享已有数据,发生修改时再分别保存变化,不必每次都复制整个数据库。
Xata 兼容性好,但分支能力较基础。Neon 在 Postgres 兼容和分支能力之间做了折中。
Dolt 和 MatrixOne 的分支操作更丰富。Dolt 在部分 SQL 执行性能上有所取舍;MatrixOne 则更偏 OLAP 场景。
所以,没有哪种实现有绝对优势。怎么选,要看你更看重兼容性还是分支语义,更看重分支操作性能还是 SQL 执行性能。
前言
在《AI Agent需要什么样的数据库?》和《对 Agent-First 数据库的畅想》中,我们讨论过在 Agent 应用下,数据库有哪些负载特征。那时我们认为,多路径探索、反复试错、频繁调试是 Agent 使用数据库主要特征之一,需要数据分支来替代传统的快照恢复机制。
近一年随着 Claude Code 等 Agent 的火爆,这些特征也愈发明显。
下面是一个典型的软件工程场景:
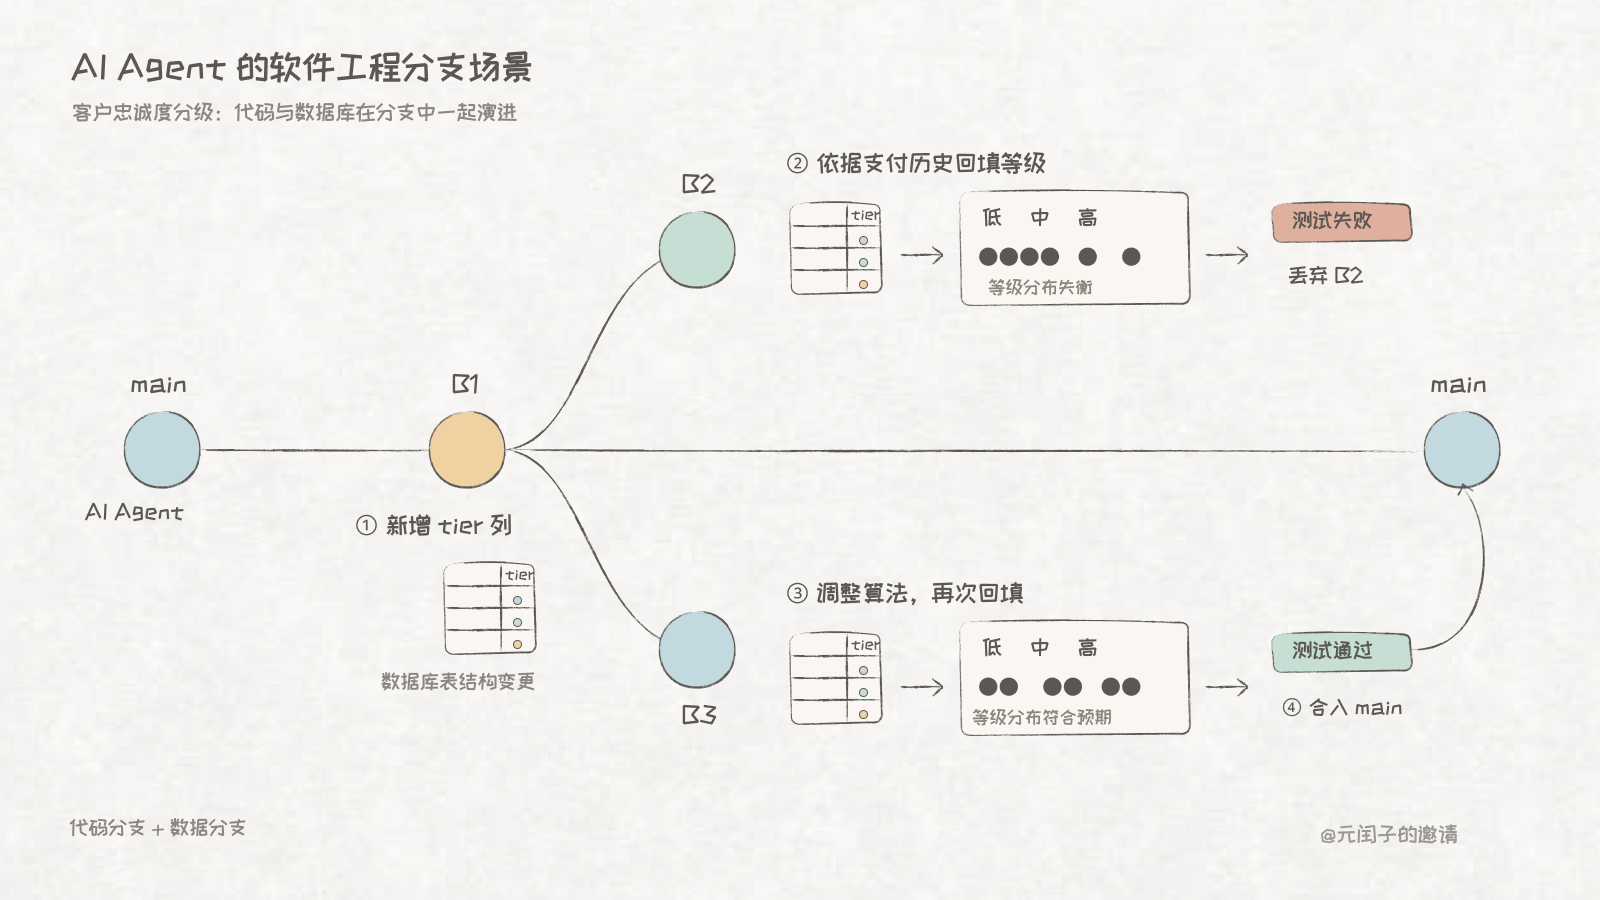
Agent 正在开发一个忠诚度分级的新需求,根据客户情况把他们分成不同等级。开发过程涉及对数据库的表结构和数据做变更:
-
从
main分支拉出特性分支B1,先给数据库新增tier列,表示客户等级。 -
先从
B1拉出B2分支,根据新开发的分级算法和支付历史计算客户等级,回填到tier列。随后进行测试回归,发现客户等级分布不符合预期,原因是分级算法有问题。 -
再从
B1拉出B3分支,根据新的分级算法计算客户等级,回填到tier列。最后测试回归通过,需求回合到main分支。
这里的分支既包含了代码分支,也有数据库的数据分支。
试想一下,如果没有数据分支,从第 2 步到第 3 步,还需要把已回填到 tier 列数据删除。效率低,也存在安全隐患。
随着 Agent 走向成熟,Agent 应用场景也会从当前的 Vibe Coding 走向生产级的应用,数据分支的也将迎来更多的用武之地。比如:
-
故障复现:在生产环境复现导致故障的数据库事务。采用二分法创建分支 + 重放事务实现。
-
数据清洗:检测并修正数据库的数据错误,提升下游的任务质量。主 Agent 持续识别各数据表的错误,派生子 Agent 执行分支->变更->验证的清洗流程。
-
蒙特卡洛树搜索(MCTS):常应用于金融、供应链管理、Text-to-SQL 等场景。每个搜索策略都可能涉及数据修改,都需要一个独立的数据分支。
-
仿真:与 MCTS 类似。
业界对数据分支的跟进热度,大都从 Databricks 以 10 亿美元收购 Neon 开始。之后,很多数据库都宣称支持了数据分支特性,它们各有各的实现方式。
那么,哪种分支的实现才是更好的呢?
本文将探讨数据分支不同的实现方式,对比它们的优缺点,尝试回答这一问题。
数据分支实现技术分类
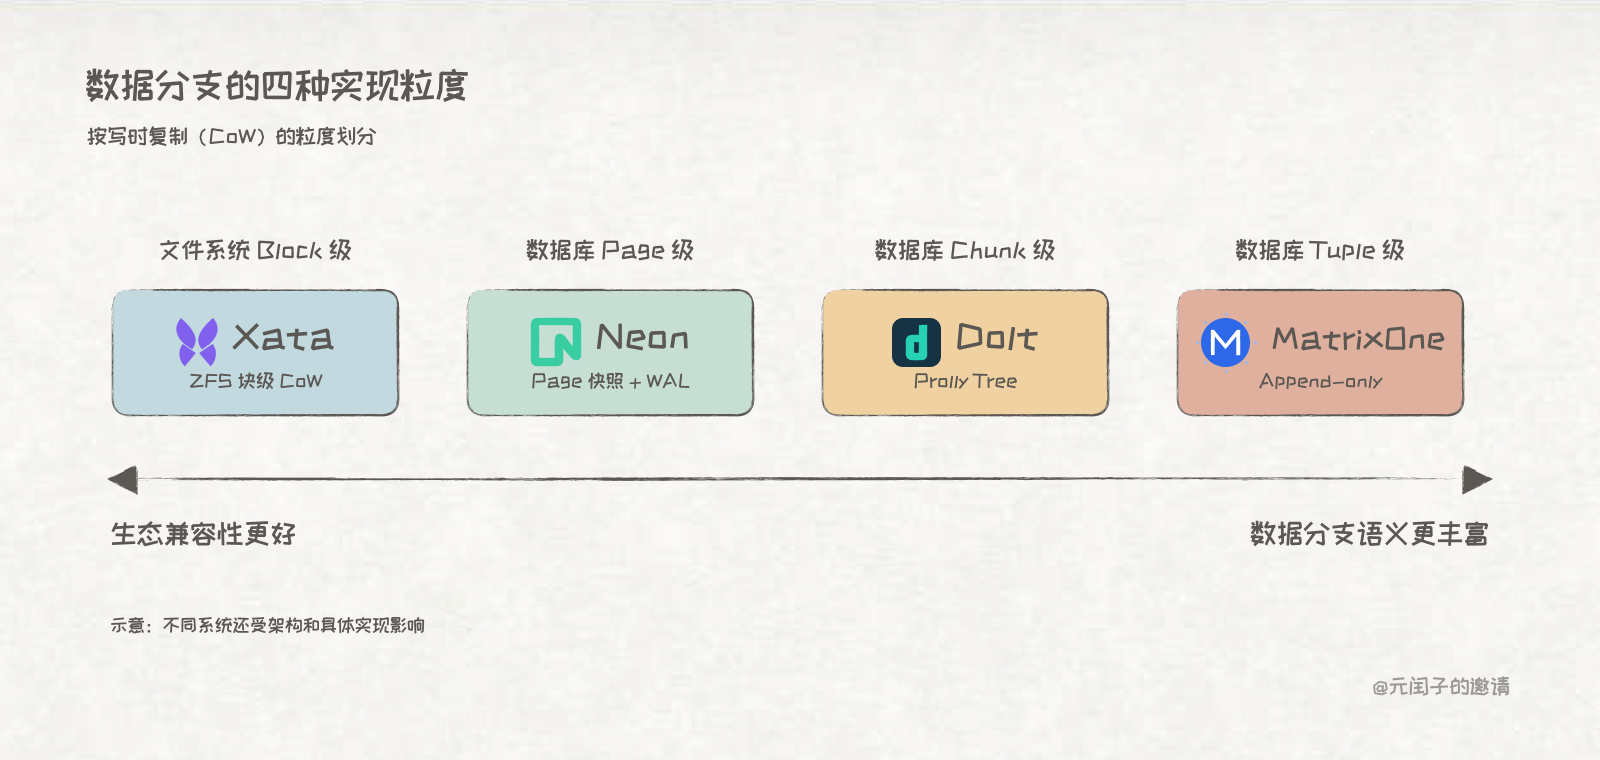
写时复制,Copy on Write(CoW),是实现数据分支绕不开的技术。根据 CoW 粒度的不同,我们可以把数据分支分成如下四类:
-
块设备 Block 级。代表产品 Xata,基于 ZFS 的 CoW 能力实现分支,数据库内核不感知,100% 兼容 Postgres。
-
数据库 Page 级。代表产品 Neon,基于 Page 快照 + 增量 WAL 实现分支,对 Postgres 做了存算分离改造,提供百毫秒级冷启动时延。
-
数据库 Chunk 级。代表产品 Dolt,基于 B 树变体的内容寻址树 Prolly Tree 实现分支,自研内核。
-
数据库 行 级。代表产品 MatrixOne,属于 HTAP 流派,更偏 OLAP。基于 LSM 引擎的 Append-only 特性实现 Tuple 级的 CoW。
文件系统 Block 级的生态兼容性最好,数据库 Tuple 级的分支语义最丰富。
Xata 的实现
Xata 基于 NVMe over Fabric(NVMe-oF) 协议构建存算分离架构。
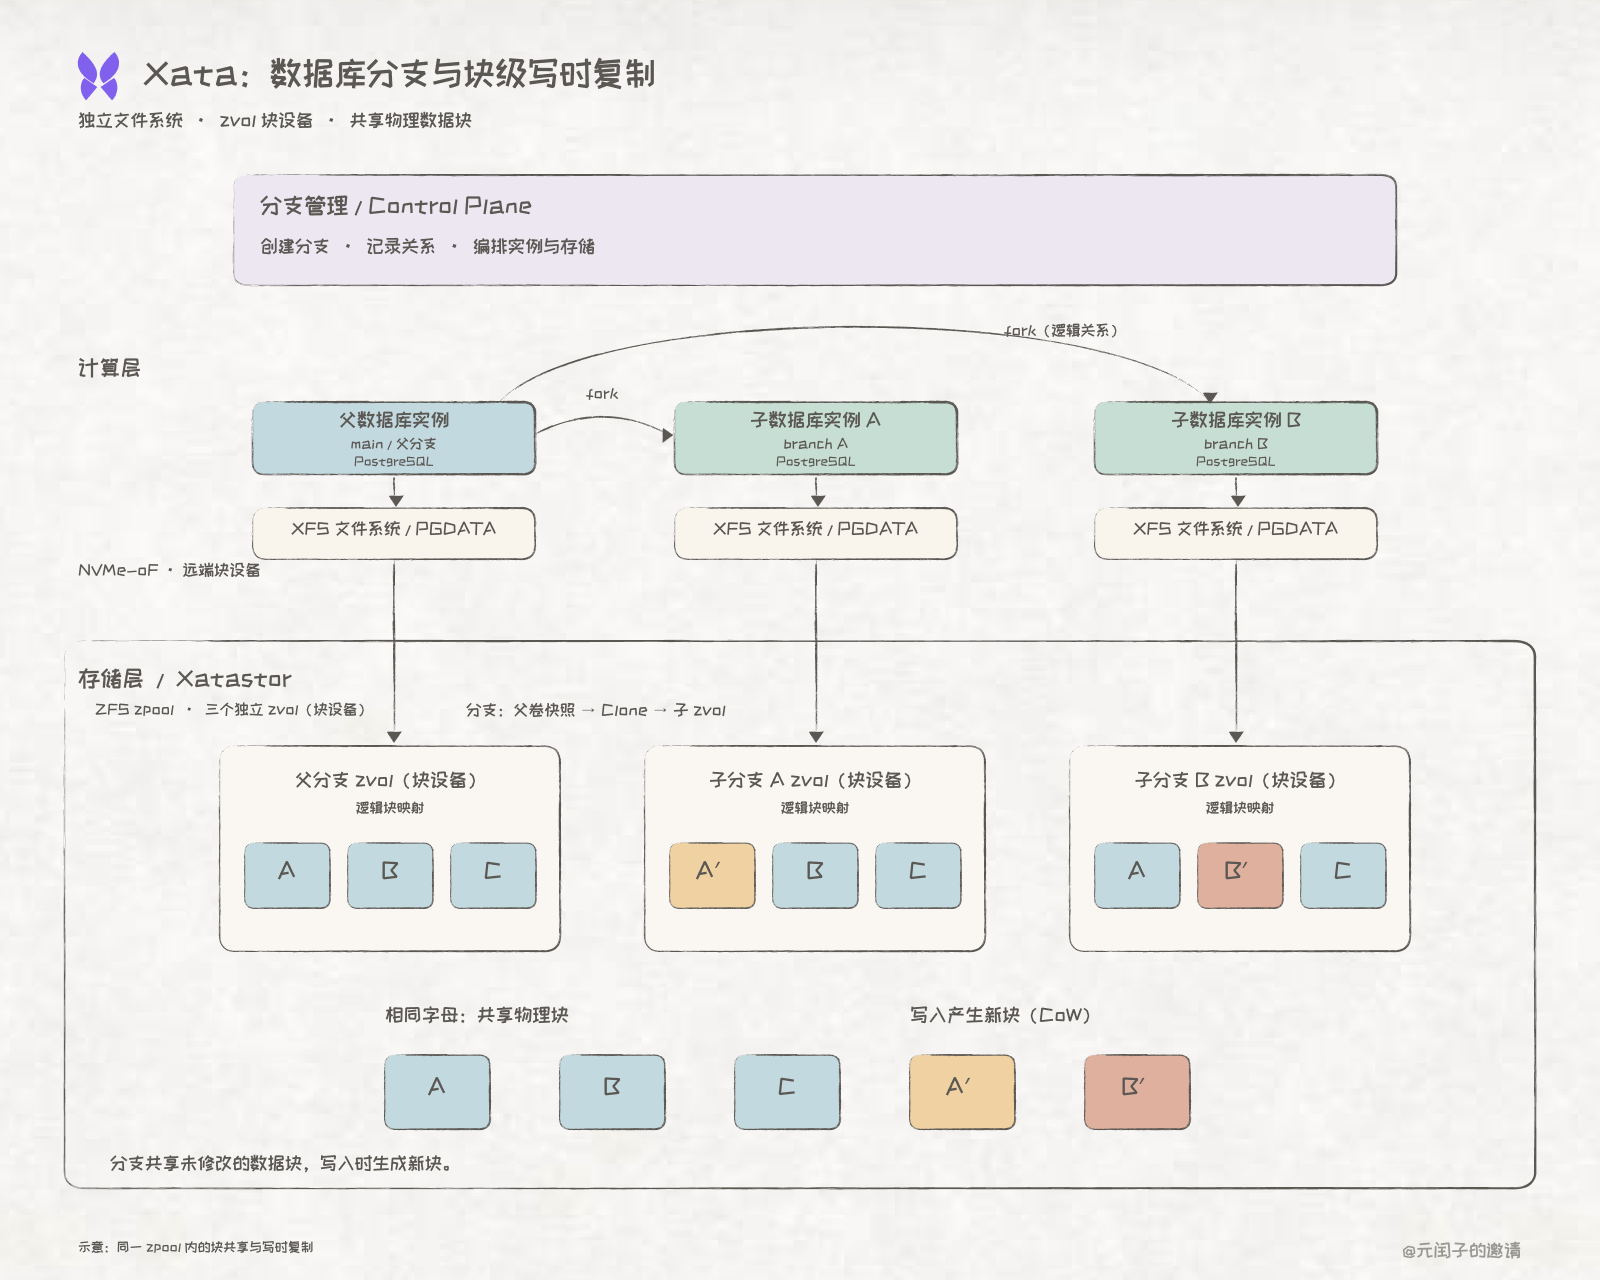
在 Xata 中,每个数据分支都有一个数据库实例,每个实例在存储层都独享一个块设备。块设备统一由 ZFS zpool 管理,每个块设备都会对应一个 zvol 卷。
新创建的子分支的数据块 A, B, C 会引用到父分支,只有当子分支修改时,才会复制一份 A’, B’,从而实现了 Block 级的 CoW。
分支的生命周期管理则由控制面完成,创建分支时,会创建子分支实例、创建新的 zvol 块设备,并让子分支实例通过 NVMe-oF 与块设备相连。
从数据库实例的视角,它看到的仍是本地文件目录,也不感知分支的存在。
所以,Xata 的策略是,数据库只管照常读写,把分支交给平台(ZFS 的存储块快照和克隆能力)。
这样做最大的好处是数据库内核无感,理论上可以支持任何数据库,生态 100% 兼容。
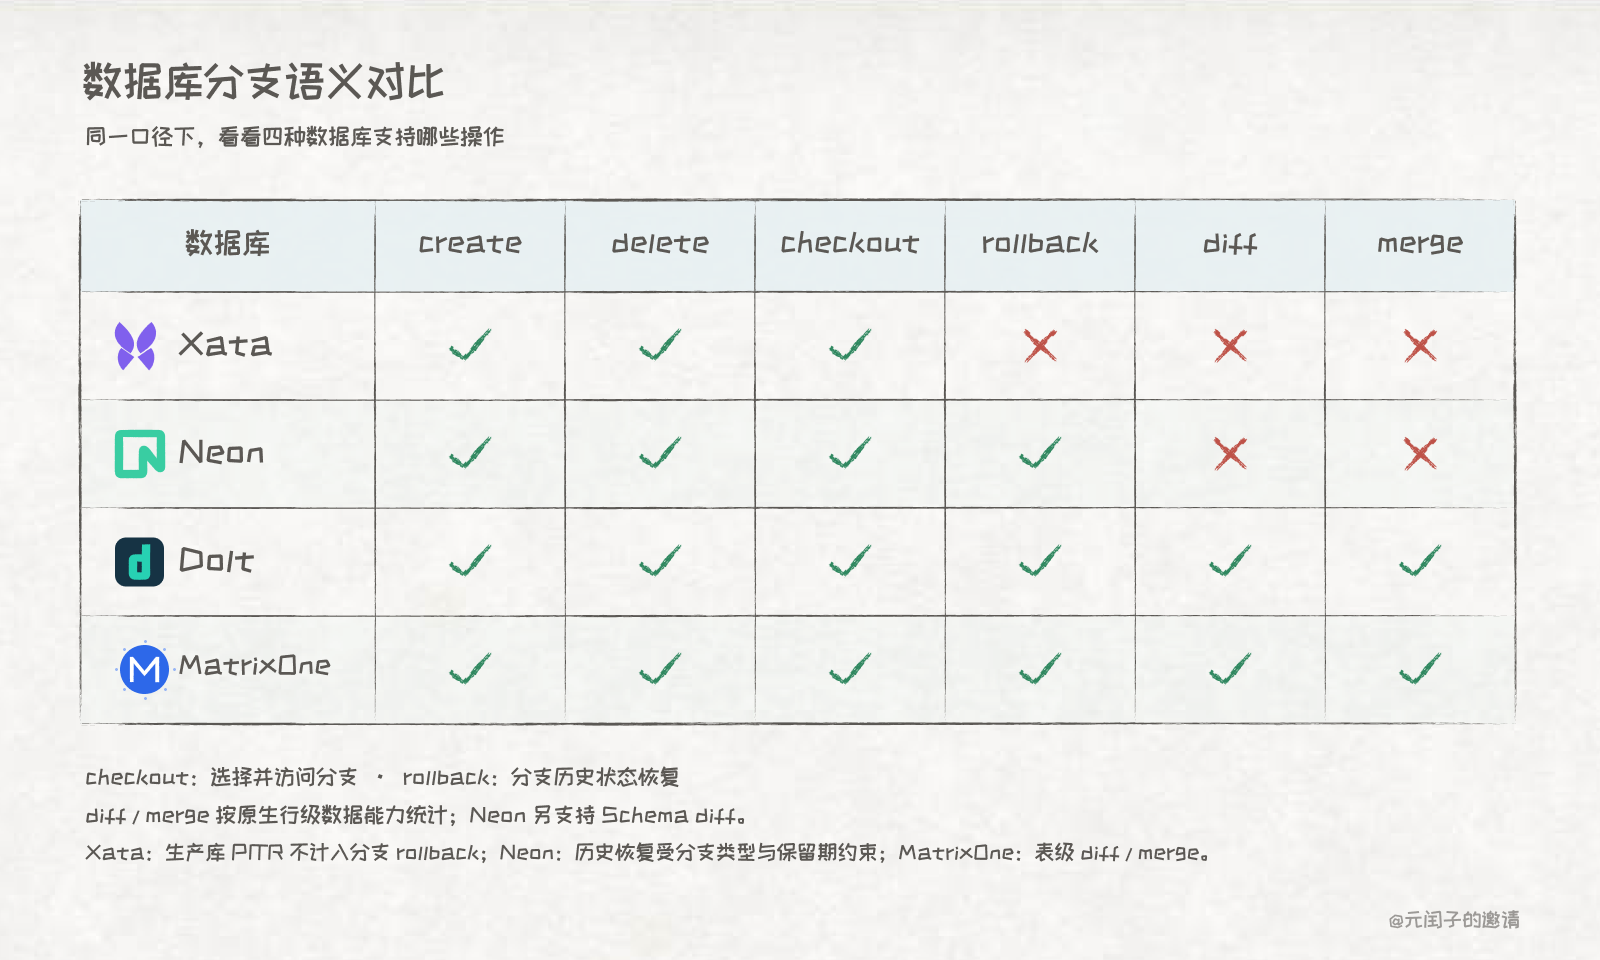
代价是,数据分支语义支持少,只能是最基础的 create、delete、checkout。
Neon 的实现
Neon 是分支数据库领域的明星,它的存算分离、Log-as-Database 架构已经成为业界标杆。更多架构和原理细节,参考《AI Agent 需要什么样的数据库?》
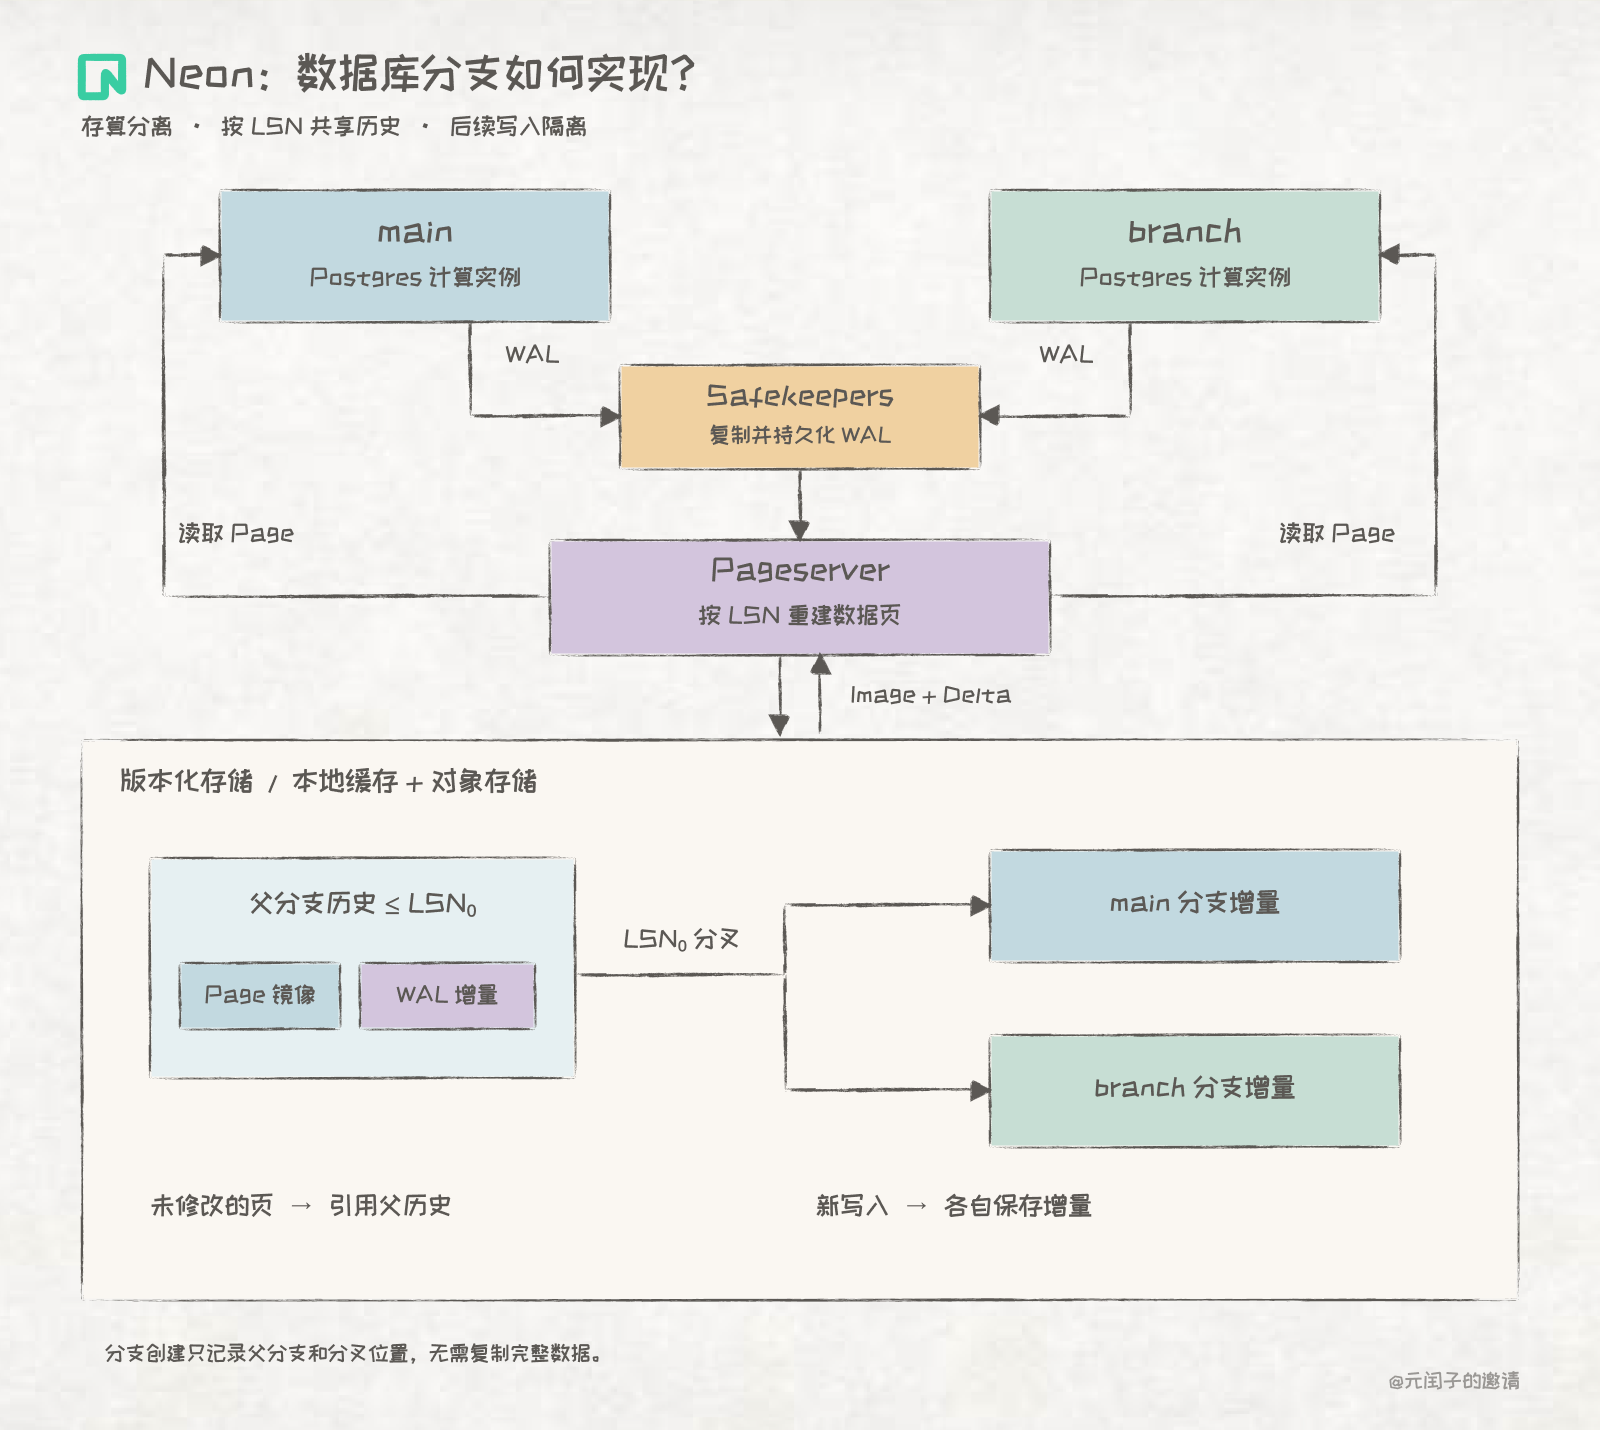
Neon 使用 LSN 来做数据版本管理,每个数据变更都会有唯一的 LSN。所以,分支管理变得很容易,只要记住分支分叉的 LSN,就能维护整个分支血缘关系。
基于 LSN 的分支管理也让 Neon 具备了 TimeTravel 能力,通过 Page 镜像 + WAL 增量回放,就能让分支回滚到任意的时间点。这是 Neon 比 Xata 多出的分支语义,rollback。
父子分支共享分叉 LSN 之前的数据,分叉后会基于不同的 WAL 完成 Page 重建,所以,CoW 的粒度是 Page 级。
Neon 改造了 Postgres 的存储引擎,把数据分支能力构筑在数据库内核,构建了基本完整的分支语义 create、delete、checkout、rollback。
Neon 仍是经典的 B-Tree 引擎,仍适用于传统的数据库负载,而且计算层还是 Postgres 实例。
所以,Neon 的策略是,够用的分支语义 + PostgresSQL 兼容。这种 Trade-Off 设计,也正是 Neon 广受欢迎的主要原因之一。
Dolt 的实现
Neon 让 Postgres 具备了数据分支能力,Dolt 则是面向数据分支重新设计了数据库。
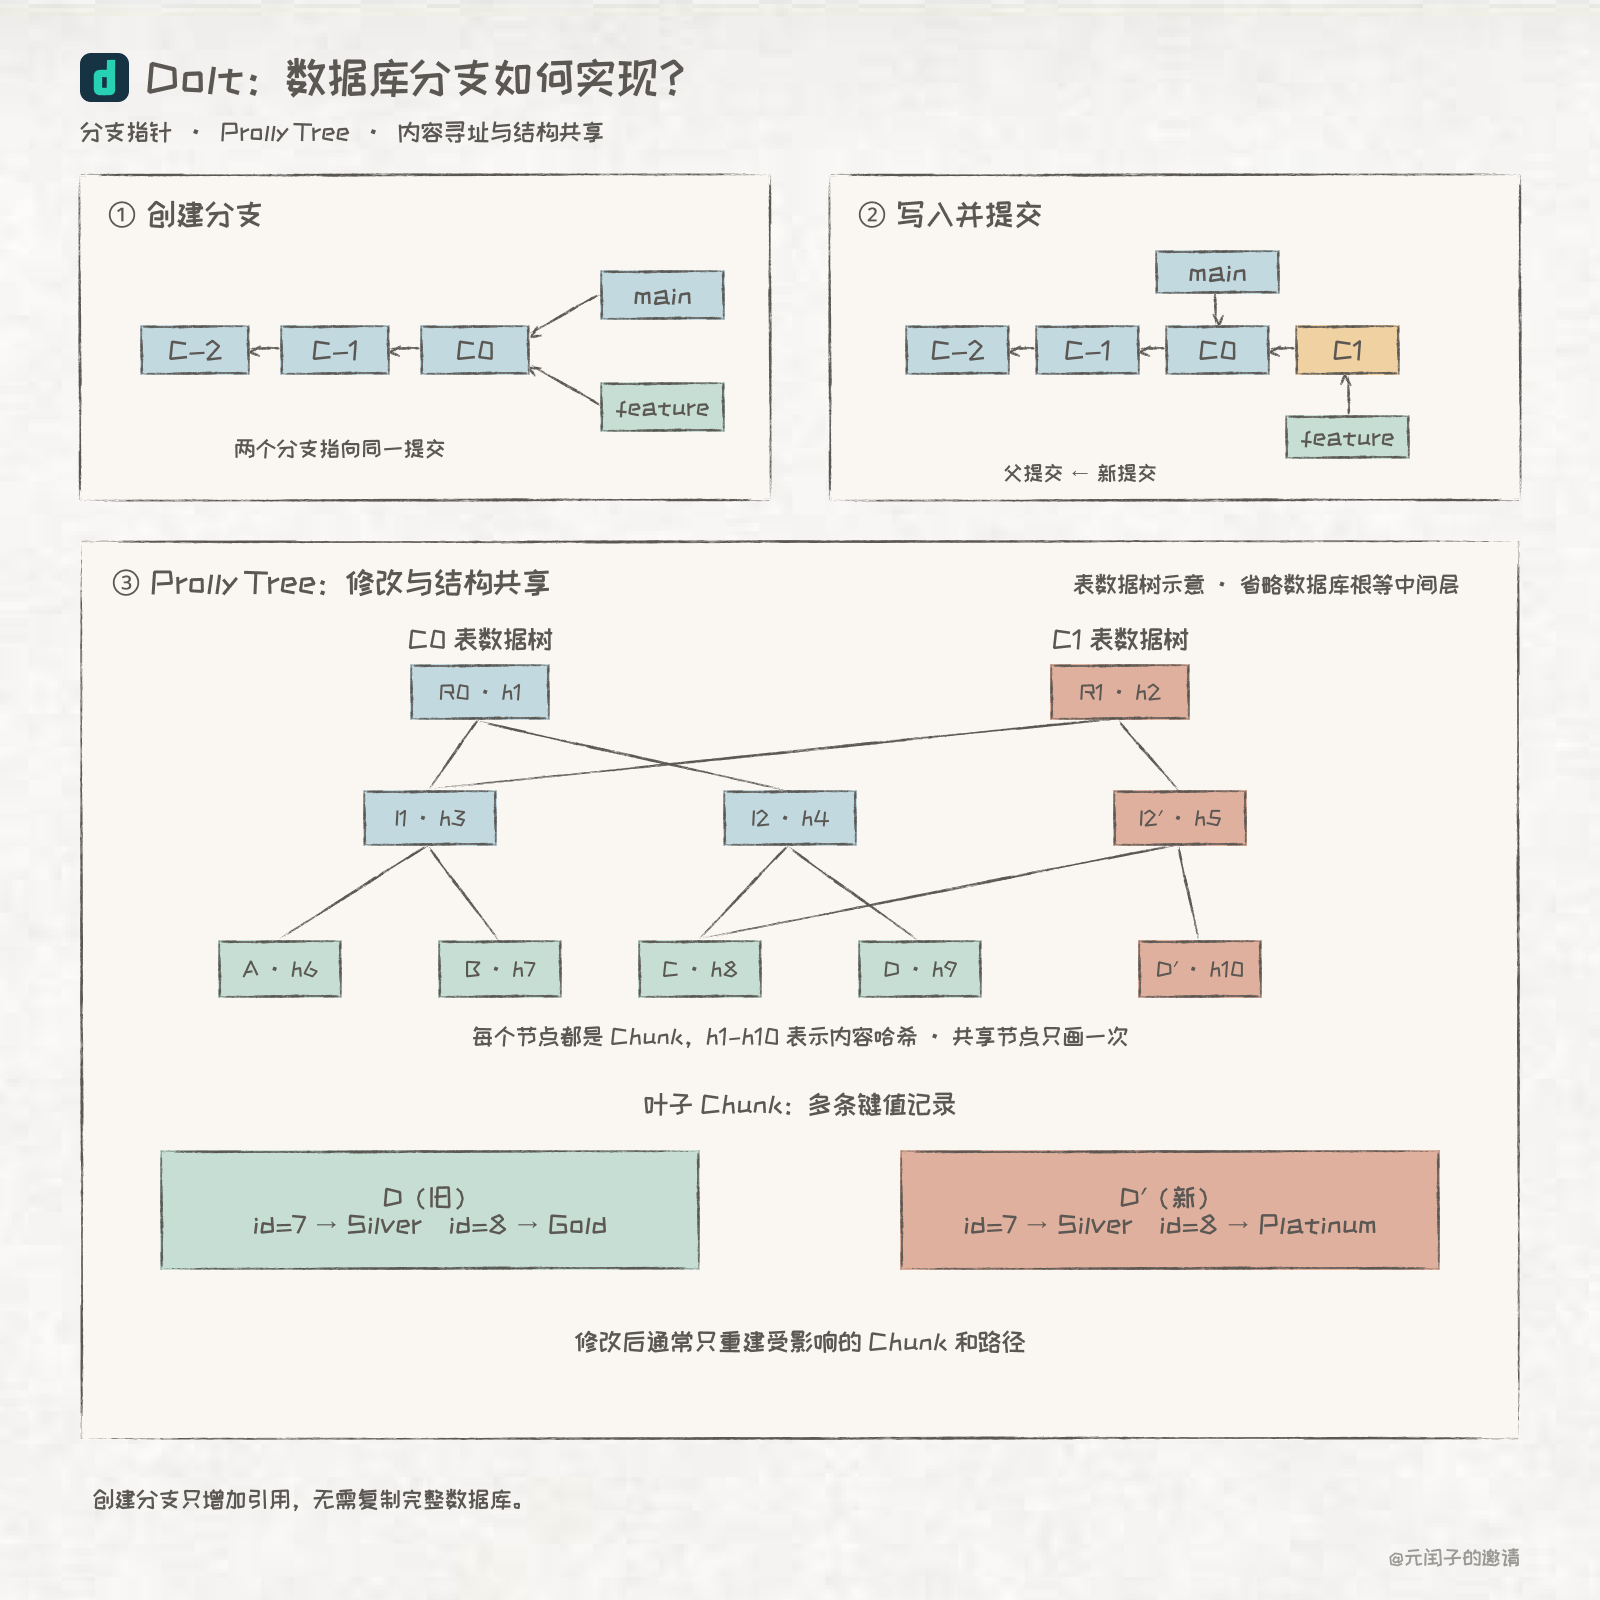
Dolt 走类似 Git 的分支管理路线,通过 DAG 来维护分支血缘,每次 commit 对应 DAG 中的一个节点。刚拉分支时,父子分支会指向同一 commit 点,随着数据写入会逐渐分化。
这也意味着,Dolt 必须显式 commit 才能回滚。要做到 Neon 一样的 TimeTravel,就需要每次修改都 commit,但版本管理开销也会随之增大。
DAG 只是管理,Dolt 实现数据分支语义的核心是 Prolly Tree,全称 Probabilistic B-Tree,也叫内容寻址树。
Prolly Tree 是 B-Tree 的变体,每个节点为一个 Chunk。Chunk 的大小通过内容定义分块算法动态划分,目标是 4K 大小。每个 Chunk 包含多行记录,且有一个内容哈希值。
数据存储在叶子节点,非叶子节点存储的是叶子节点的内容哈希值。所以,只要有数据修改,必然会产生一颗新的 Tree。
内容哈希值能够帮助 Dolt 快速定位到修改数据所在的 Chunk,因此非常适合用来做 diff 和 merge。
Dolt 已经不再是传统的 B-Tree 引擎,它专门为数据分支场景设计,具备了相当完善的分支语义,但代价是读写性能变差。
Dolt 官方博客数据,对比传统的 B-Tree,Prolly Tree 的读性能慢 20%,批量写性能慢 67%。特别是开启自动 commit 写时,性能慢 3 倍!
所以,Dolt 的策略是牺牲一些 SQL 读写性能,换来更完善的分支语义支持。
MatrixOne 的实现
前面提到的都是 OLTP 数据库,MatrixOne 则是基于 LSM-Tree 的 HTAP 数据库,更偏 OLAP。
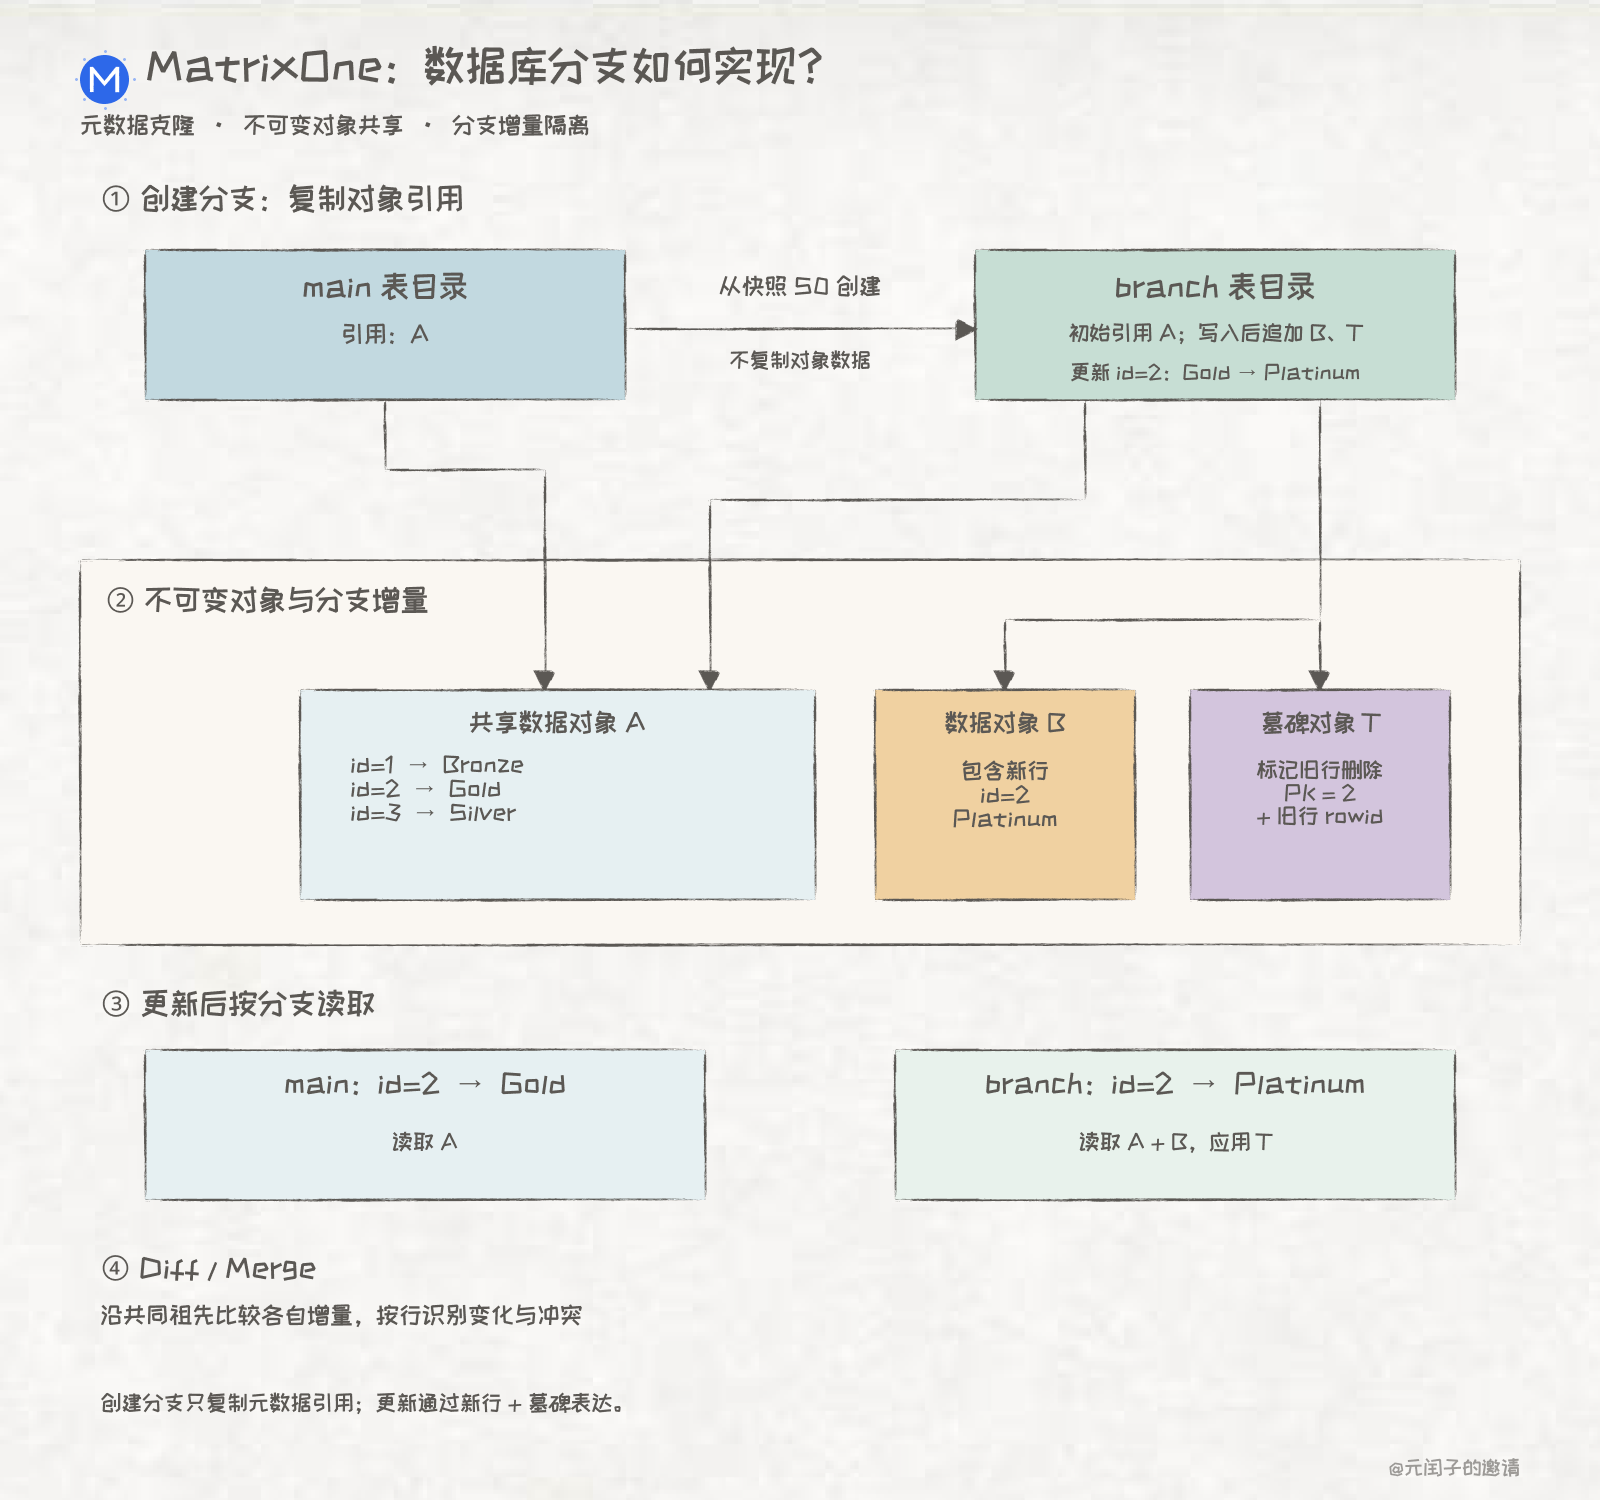
MatrixOne 官方原理说明 · Git4Data 论文
LSM-Tree 的特点是 Append-only,任何一次数据新增、修改、删除都会被记录下来,而且能随机读,这就很适合做分支。
WAL 也会记录任何一次数据变更,但只能靠顺序回放,无法高效随机读。
MatrixOne 实现分支的核心机制就是 Append-only + MVCC。
Append-only 奠定了存储基础,父子分支共享不可变的数据对象,各自修改以增量记录的方式保存在新的数据对象中,实现了行级 CoW。
MVCC 提供分支管理基础,能判断某个时间点哪些版本可见,结合分支元数据,实现父子分支各看各的数据。
在此基础上,MatrixOne 很容易就实现了相对完善的分支语义。比如 diff、merge,可通过对父子分支的增量数据对象做一次按行聚合比较实现。
所以,MatrixOne 很好地利用了 LSM-Tree 的 Append-only 特性,扩展了对数据分支的支持。
评测对比
网上还没有对这 4 款数据库统一拉通测评,只能东拼西凑拿到一些信息。
分支语义对比
在分支语义上,Dolt 和 MatrixOne 支持最丰富,Neon 够用,Xata 刚入门槛。
分支创建性能对比
Xata 和 Neon 为每个分支都创建一个独立的计算实例,提供了最彻底的隔离。但因为涉及实例启动和建立连接,性能相对较差。Xata 官方数据为 1~2s,Neon 网上实测数据也在 1s 左右。
Dolt 和 MatrixOne 因为不涉及实例创建,分支创建时延更低,都达到了 10ms 左右。
SQL 执行性能对比
Xata、Neon、MatrixOne 都没有对传统引擎内核做大改,只是扩展了对数据分支的支持,SQL 执行性能不会太差。
Dolt 把存储引擎换成了 Prolly Tree,是专门针对分支优化的设计。官方数据显示,Doltlite(把 Prolly Tree 替换到 SQLite 中)对比 SQLite,读性能慢 20%、批量写性能慢 67%、自动 commit 写性能慢 3 倍。
最后
本文主要介绍了 4 类数据分支的实现方案。
Xata 生态兼容最好,但分支语义支持有限。
Neon 是一个很好的折中方案,因此也最受欢迎。
Dolt 专门为数据分支设计,分支语义支持完善,分支创建性能高,但代价是 SQL 执行性能损耗大。
MatrixOne 则是在 LSM-Tree 的基础上扩展了分支语义的支持,分支语义和性能都挺好,但生态较弱。
所以,数据分支没有哪种实现有绝对的优势,它们都在各方面做了权衡。
文章配图
配图由 ChatGPT + Figma 插件生成,可以在 用Keynote画出手绘风格的配图 中找到配图风格。
参考
[1] Inside Xatastor: ZFS + NVMe-oF for millions of Postgres databases, Xata
[2] Deep dive into Neon storage engine, Neon
[3] Storage Engine, DoltHub
[4] How Fast Is DoltLite?, DoltHub
[5] Git4Data: Database-Native Version Control for AI Agents, MatrixOrigin & Purdue University
[6] BranchBench: Aligning Database Branching with Agentic Demands, Elaine Ang 等
(完)